مدل Kimi K3 چیست؟ بررسی کامل معماری ۲.۸ تریلیونی، بنچمارکها و مقایسه با Claude و GPT

Kimi K3 اولین مدل open-weight کلاس ۲.۸ تریلیون پارامتر با ۱ میلیون توکن context است. بنچمارکها، معماری و مقایسه با Claude Fable 5 را ببین و اشتراکش را با تحویل آنی از پیکسول بگیر.
توی جولای ۲۰۲۶، Moonshot AI مدل Kimi K3 رو معرفی کرد؛ اولین مدل وزنباز توی کلاس ۲.۸ تریلیون پارامتر. مدلی که توی بنچمارکهای کدنویسی طولانیمدت و agentic با Claude Fable 5 و GPT-5.6 Sol رقابت میکنه و توی بعضی جاها حتی جلوتر میزنه. پنجرهی بافت واقعیش هم ۱ میلیون توکنه.
اگه برنامهنویس یا پژوهشگری هستی که به قدرت agentic و context بلند نیاز داری، اشتراک Kimi AI رو با تحویل آنی از پیکسول بگیر. پلنهای Plus، Pro و Ultra مستقیم روی اکانت خودت فعال میشن.
معماری و ویژگیهای کلیدی Kimi K3
Kimi K3 روی معماری ترکیبی از متخصصان (Mixture-of-Experts) ساخته شده و نوآوریهای جدی توی توجه و مسیریابی داره:
| مشخصه فنی | مقدار |
|---|---|
| کل پارامترها | ۲.۸ تریلیون |
| پارامترهای فعال | ۱۰۴ میلیارد |
| تعداد متخصصان (Experts) | ۸۹۶ (۱۶ فعال + ۲ مشترک) |
| تعداد لایهها | ۹۳ (۶۹ KDA + ۲۴ Gated MLA + ۱ Dense) |
| پنجرهی بافت | ۱,۰۴۸,۵۷۶ توکن |
| دقت ذخیرهسازی بومی | وزنهای MXFP4 / فعالسازیهای MXFP8 |
| کدگذار بصری | MoonViT-V2 (۴۰۱ میلیون پارامتر) |
نوآوریهای اصلی:
Kimi Delta Attention (KDA) و Attention Residuals برای حفظ جریان اطلاعات توی توالیهای خیلی بلند
Stable LatentMoE با بازدهی مقیاسپذیری ۲.۵ برابر نسل قبل
کوانتایش آگاه از آموزش، از مرحلهی SFT به بعد
چندوجهی بودن بهصورت بومی: درک متن، تصویر و ویدیو توی یه فضای واحد
حالت استدلال «فقط-تفکر» با سطح تلاش قابل تنظیم (پیشفرض روی حداکثر)
بنچمارکها و مقایسهی عملکرد
با تنظیم تلاش استدلالی روی حداکثر، Kimi K3 نتایج سطح مرزی ثبت کرده:
GPQA Diamond: ۹۳.۵
Terminal-Bench 2.1: ۸۸.۳
BrowseComp: ۹۱.۲
FrontierSWE: ۸۱.۲
DeepSWE: ۶۷.۵
MathVision (با کد پایتون): ۹۷.۸
DeepSearchQA: ۹۵.۰
AA Intelligence Index: حدود ۵۷ (نزدیک به مدلهای top بسته)
توی Frontend Code Arena رتبهی اول رو گرفته و از Claude Fable 5 هم جلو زده. توی خیلی از تسکهای coding و agentic بهتر از Claude Opus 4.8 و GPT-5.5 عمل میکنه، هرچند توی overall هنوز Claude Fable 5 و GPT-5.6 Sol جلوترن.
اگه این نتایج هیجانزدهات کرده، همین حالا اشتراک Kimi AI رو از پیکسول با تحویل آنی سفارش بده.
کاربردهای واقعی و مطالعات موردی
قدرت واقعی Kimi K3 فراتر از عددهای بنچمارکه و توی سناریوهای عملیاتی هم ثابت شده:
بهینهسازی هستهی AttnRes روی GPUهای Hopper: زمان اجرا از ۲۸۳.۶ میلیثانیه به ۱۱۴.۴ میلیثانیه رسیده
ساخت خودمختار کامپایلر MiniTriton (شبیه Triton) با کارایی همتراز یا حتی بهتر
طراحی یه تراشهی نیمههادی ۴ میلیمتر مربعی توی ۴۸ ساعت با نرخ بیش از ۸,۷۰۰ توکن بر ثانیه
بازتولید روابط اخترفیزیک توی ۲ ساعت بهجای ۱ تا ۲ هفته (با مرور بیش از ۲۰ مقاله و تولید ۳۰۰۰ خط کد)
تحلیل ۳۹۱ رویداد امواج گرانشی با ۲۰ عامل بهصورت همزمان
گزینهی مناسبیه برای کدنویسی agentic و طولانیمدت، تحلیل کدبیسهای بزرگ، پژوهش علمی، اتوماسیون اداری و کارهای multimodal.
نقاط قوت، محدودیتها و مخاطب هدف
نقاط قوت اصلی:
وزنهای کاملاً باز (اولین مدل open توی کلاس ۳ تریلیونی)
پنجرهی بافت واقعی ۱ میلیون توکن بههمراه prefix caching قوی
قدرت بالا توی coding طولانیمدت و agentic
هزینهی API رقابتی (مخصوصاً با تخفیف ۹۰ درصدی روی توکنهای کششده)
سانسور کمتر نسبت به مدلهای غربی
multimodal بودن بهصورت بومی، بدون نیاز به ماژول جدا
محدودیتها:
کمی عقبتر از Claude Fable 5 و GPT-5.6 Sol توی عملکرد کلی
حساسیت به حفظ تاریخچهی تفکر
latency و هزینهی بالاتر توی حالت max reasoning برای تسکهای ساده
اجرای محلیش نیاز به سختافزار سنگین داره (حدود ۱.۵ ترابایت)
مخاطب هدف: توسعهدهندههای ایرانی که با Cursor کار میکنن، تیمهای agentic، پژوهشگرا و هرکسی که به کنترل بیشتر، context بلند و هزینهی منطقی نیاز داره.
نتیجهگیری: وقتشه قدرت Kimi K3 رو تجربه کنی
Kimi K3 یه نقطهی عطف توی دموکراتیزه کردن هوش سطح مرزیه. با ترکیب معماری پیشرفته، بنچمارکهای قوی و وزن باز، رقابت توی هوش مصنوعی رو وارد یه مرحلهی جدید کرده.
اگه میخوای بدون دردسر و با سرعت از این قدرت استفاده کنی، بهترین راه خرید اشتراک Kimi AI از پیکسوله.
آنی · اصل · امن · پشتیبانی
همین حالا پلن Plus، Pro یا Ultra رو انتخاب کن و دسترسی مستقیم به Kimi K3 و Kimi Code رو روی اکانت خودت فعال کن.
دنبال یه IDE اجنتیک هستی؟ اشتراک Cursor رو ببین. برای کدنویسی با مدلهای آنتروپیک هم اشتراک Claude توی پیکسول موجوده.
برای مقایسه با مدلهای دیگه هم یه سر به دستهی اشتراکهای هوش مصنوعی پیکسول بزن.
پیکسول یه فروشگاه آنلاین تخصصیه برای محصولات دیجیتال با تحویل آنی: گیفتکارت، اشتراک هوش مصنوعی، ابزارهای برنامهنویسی و خدمات تلگرام.
این مطلب را بفرستید
لینک، تلگرام، یا منابع منتخب گوگل
مطالب مرتبط
همه مطالب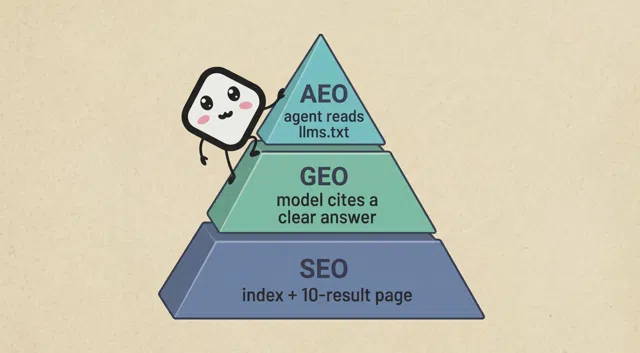
تفاوت SEO و GEO و AEO چیست؟
ثبت سایت در سرچکنسول و ساخت سایتمپ دیگر برای دیدهشدن در عصر هوش مصنوعی کافی نیست؛ چون پاسخ به سوالات کاربران بهجای صفحات گوگل، مستقیماً به ابزارهایی مثل ChatGPT و Perplexity منتقل شده است. برای حضور مؤثر، باید سه لایه بهینهسازی را بشناسید: SEO برای کسب رتبه و کلیک در فهرست کلاسیک جستجو، GEO برای نقلقول شدن و تبدیل شدن به منبع پاسخ مدلهای زبانی، و AEO برای درک سریع ساختار سایت توسط ایجنتهای خودمختار خرید و کدنویسی. این سه لایه رقیب هم نیستند بلکه روی هم سوار میشوند؛ سئو پایه و پیشنیاز خواندهشدن سایت است، GEO محتوا را به جملاتی شفاف و قابلنقل برای چتباتها تبدیل میکند، و AEO با راهکارهایی مثل فایل llms.txt و خروجی سبک مارکداون، مسیر اجرای تسکها را برای ایجنتها هموار میسازد. در این راهنما تفاوت کاربرد، سناریوهای عملی و اولویتهای پیادهسازی هرکدام را بررسی کردهایم.
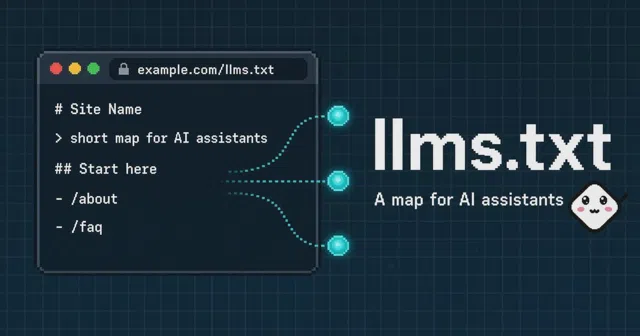
llms.txt چیست؟ ساختار استاندارد پیشنهادی و آموزش فعالسازی در وردپرس
llms.txt چیست و چطور در وردپرس فعال میشود. ساختار استاندارد، تفاوت با robots.txt و فعالسازی با Yoast یا AIOSEO.

تفاوت ChatGPT Plus و Pro | کدام را بخریم؟ (راهنمای ۲۰۲۶)
تفاوت chatgpt plus و pro را کامل بدانید.برای کدنویسی و Codex ،Plus کافی است یا Pro؟